Exploring the TypeScript Compiler Part 2: Inside the TypeScript Compiler
本記事は tskaigi 2026 Day2の制約と時代から読み解くTypeScriptコンパイラ設計史の増補改訂版の Part 2 です。
- Part 0: Overview
- Part 1: Why Go?
- Part 2: Inside the TypeScript Compiler
- Part 3: Why TypeScript(Coming soon)
- Part 4: Roslyn and the Red-Green Tree(Coming soon)
- Part 5: JavaScript Madness🫠(Coming soon)
- Part 6: What Changes with Go(Coming soon)
前回は、既存のデータ構造を保ったまま移植しやすいことが、Go を選ぶ理由の1つだと説明しました。今回はそのデータ構造を理解するために、ソースコードから型チェックまでの流れを追います。
速習 TypeScriptコンパイラ
CAUTION
制御フロー解析や型推論の詳細には立ち入りません。また、Transformer や Emitter に関しては触れません。
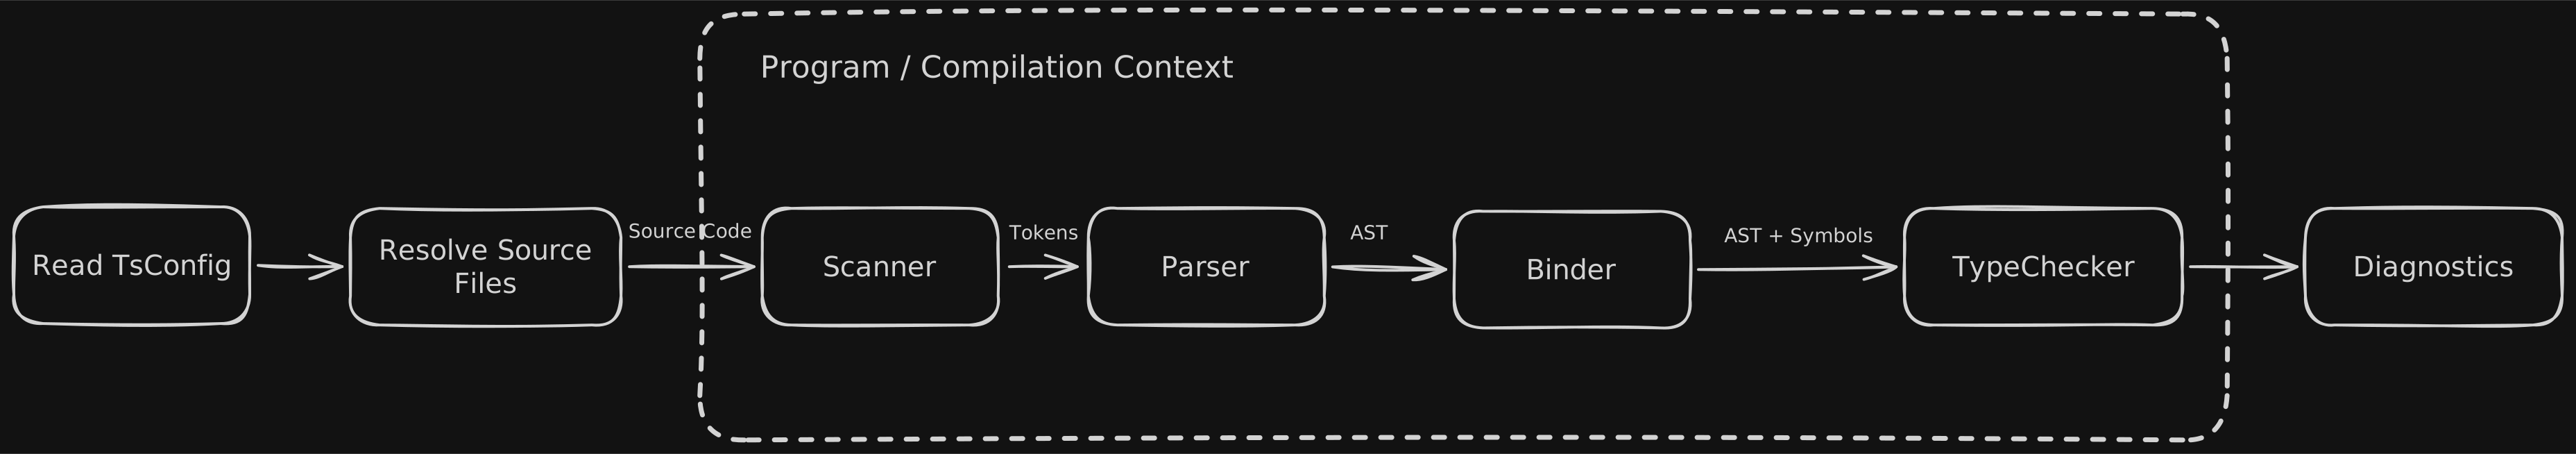
TypeScript コンパイラがどのような処理を通って型チェックが実行されるのかを速習します。おおまかな流れとして次のようなフローになっています。
Programの作成
典型的な実行では、まず tsconfig が読まれ、検査対象の .ts ファイル群が決定されます。これらを元にProgramというオブジェクトを初期化します。Program は複数のファイルやオプションを管理し、後続の Parser や Binder, Checker などの処理を連携させます。
Parse
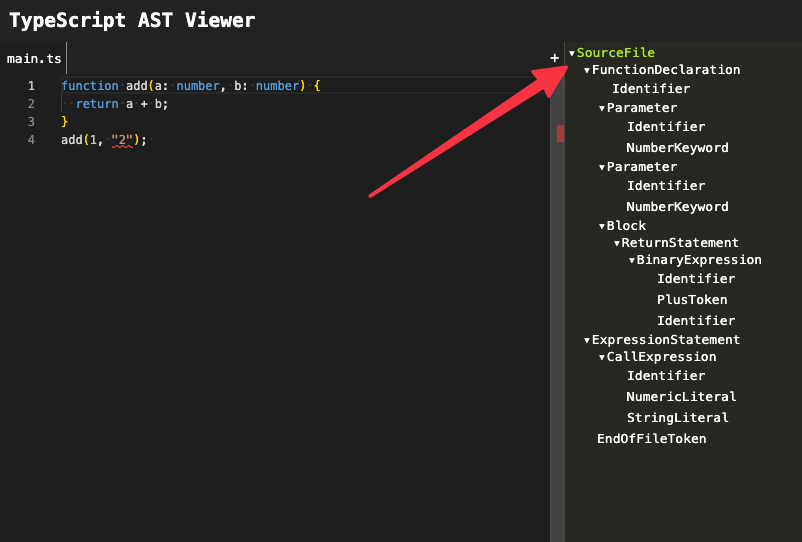
解析対象の.ts ファイルは scanner を通ってトークン列へと変換されます1。その後トークンから Parser が AST を作成します。ここは別言語のコンパイラでも非常に一般的な流れです。TS AST Viewer で生成されたものを確認できます。
TypeScript において、AST のルートはSourceFileという Node 名をしています。頭の片隅においておくと内部を見ていくにあたってスムーズです。
意味解析
Parser が作る AST は、コードの構文上の構造を表します。しかし、これだけだと型エラーなどを検知するには足りません。 AST 単体で Syntax は正しいが Semantics(意味)的に NG なケースは捕まえにくいからです。
次のような簡単なコードを考えてみましょう。
function add(a: number, b: number) {
  return a + b;
}
add(1, "2"); // Argument of type 'string' is not assignable to parameter of type 'number'.
add(1, "2") の文法自体は正しいものの、引数の型が合わないためエラーになります。 人の目なら、add の呼び出しで型エラーが出るとすぐに分かります。
一方でコンパイラは AST のみではそれを判断できません。AST はコードの構文上の構造を表すため、型を検査するには、この add がどの宣言を指し、その関数がどんな引数を受け取るのかを調べる必要があります2。
ここで登場するのが Symbol と、それを構築する Binder です。
Symbol
Symbol は識別子(Identifier)が指している宣言や種類を表し、名前解決の結果を扱うための基本単位です。スコープは主に AST 上のコンテナと、その locals などの SymbolTable を使って表現されます。ES6の Symbol とは全くの別物であることに注意してください。
先ほどのサンプルコードを再度見てみましょう。
// addという名前の関数の宣言
function add(a: number, b: number) {
  return a + b;
}
add(1, "2"); // addという名前のものへの参照一目で、2つ目のaddが定義済みのadd関数を呼び出しているとわかります。しかし、AST はあくまで文法情報を木構造として表しているものなので、名前が同じaddでも別々の Identifier ノードとして扱っています。
ここで出てくるのが Symbol でコード上の名前や参照を同じ意味上の実体にまとめる役割を担います。
export interface Symbol {
  flags: SymbolFlags; // 種類(変数?関数?クラス?)
  escapedName: __String; // 名前, stringのbrand type
  declarations?: Declaration[]; // この名前が宣言されている AST ノード
  members?: SymbolTable; // classやinterface のメンバー
  exports?: SymbolTable; // モジュールのexport
}- どんな名前か
- どこで宣言されたか、元の AST ノードへの参照 (declarations)
- どんな種類のシンボルか (BlockScopedVariable, Function, Class, など.)
といった情報を持っているオブジェクトになります。
また SymbolTable というものがありますが非常に単純で名前に対する Symbol を記録する Map です。
export type SymbolTable = Map<__String, Symbol>;Binder
AST から Symbol を生成するのがBinderというコンポーネントになります。Binder はシンボルを作り、それをもとにしたシンボルテーブルやフロー解析のためのノードを構築します。
先ほどのサンプルコードであればまず Binder はfunction add()という宣言FunctionDeclarationに到達し、ざっくり次のような Symbol を生成します。
Symbol {
  flags: Function,
  escapedName: "add",
  declarations: [(FunctionDeclarationのAST)]
}
この Symbol は AST 側、今回であればルートのSourceFileノードのlocalsというフィールドの SymbolTable に登録します。localsはそのスコープで直接宣言された名前と Symbol の対応が記録されます。また、ここは既存 AST に対して、意味解析情報の後付けしていくという独特な工程の1つです。
同時に、宣言を表す FunctionDeclaration ノードの symbol フィールドにも、この Symbol を設定します。
Binder による処理を行った結果次の図のような状態になります3。
a と b は省略)次に Binder はadd(1, "2")という部分に到達します。ここではadd関数を参照していますが、Binder はこの時点で名前を解決しません。 Binder は制御フロー解析に必要な情報だけを設定します。後続の Checker は参照先が必要になった時点で、addに対応する関数宣言の Symbol を解決します。
TypeScript と C#
TypeScript は C# のコンパイラである Roslyn と、内部の概念や用語が非常に似通っています。どちらも Microsoft で開発され、アーキテクトも同じです。
Roslyn Overviewgithub.com/dotnet/roslyn/blob/main/docs/wiki/Roslyn-Overview.md上記の Roslyn の wiki では Symbol, Compilation などの用語が解説されていたり、Bind というフェーズに関する言及もあります。これらは TypeScript コンパイラの中でも同様に登場し、責務もかなり近いです。
Roslyn の存在は非常に重要で、本シリーズの Part 4 で詳しく触れます。
Checker
お待ちかねの Checker です。Checker は AST 起点で Symbol をたどって型を計算・検索するコンポーネントです。先ほどの例で add(1, "2") の呼び出しを検査する流れを追ってみましょう。
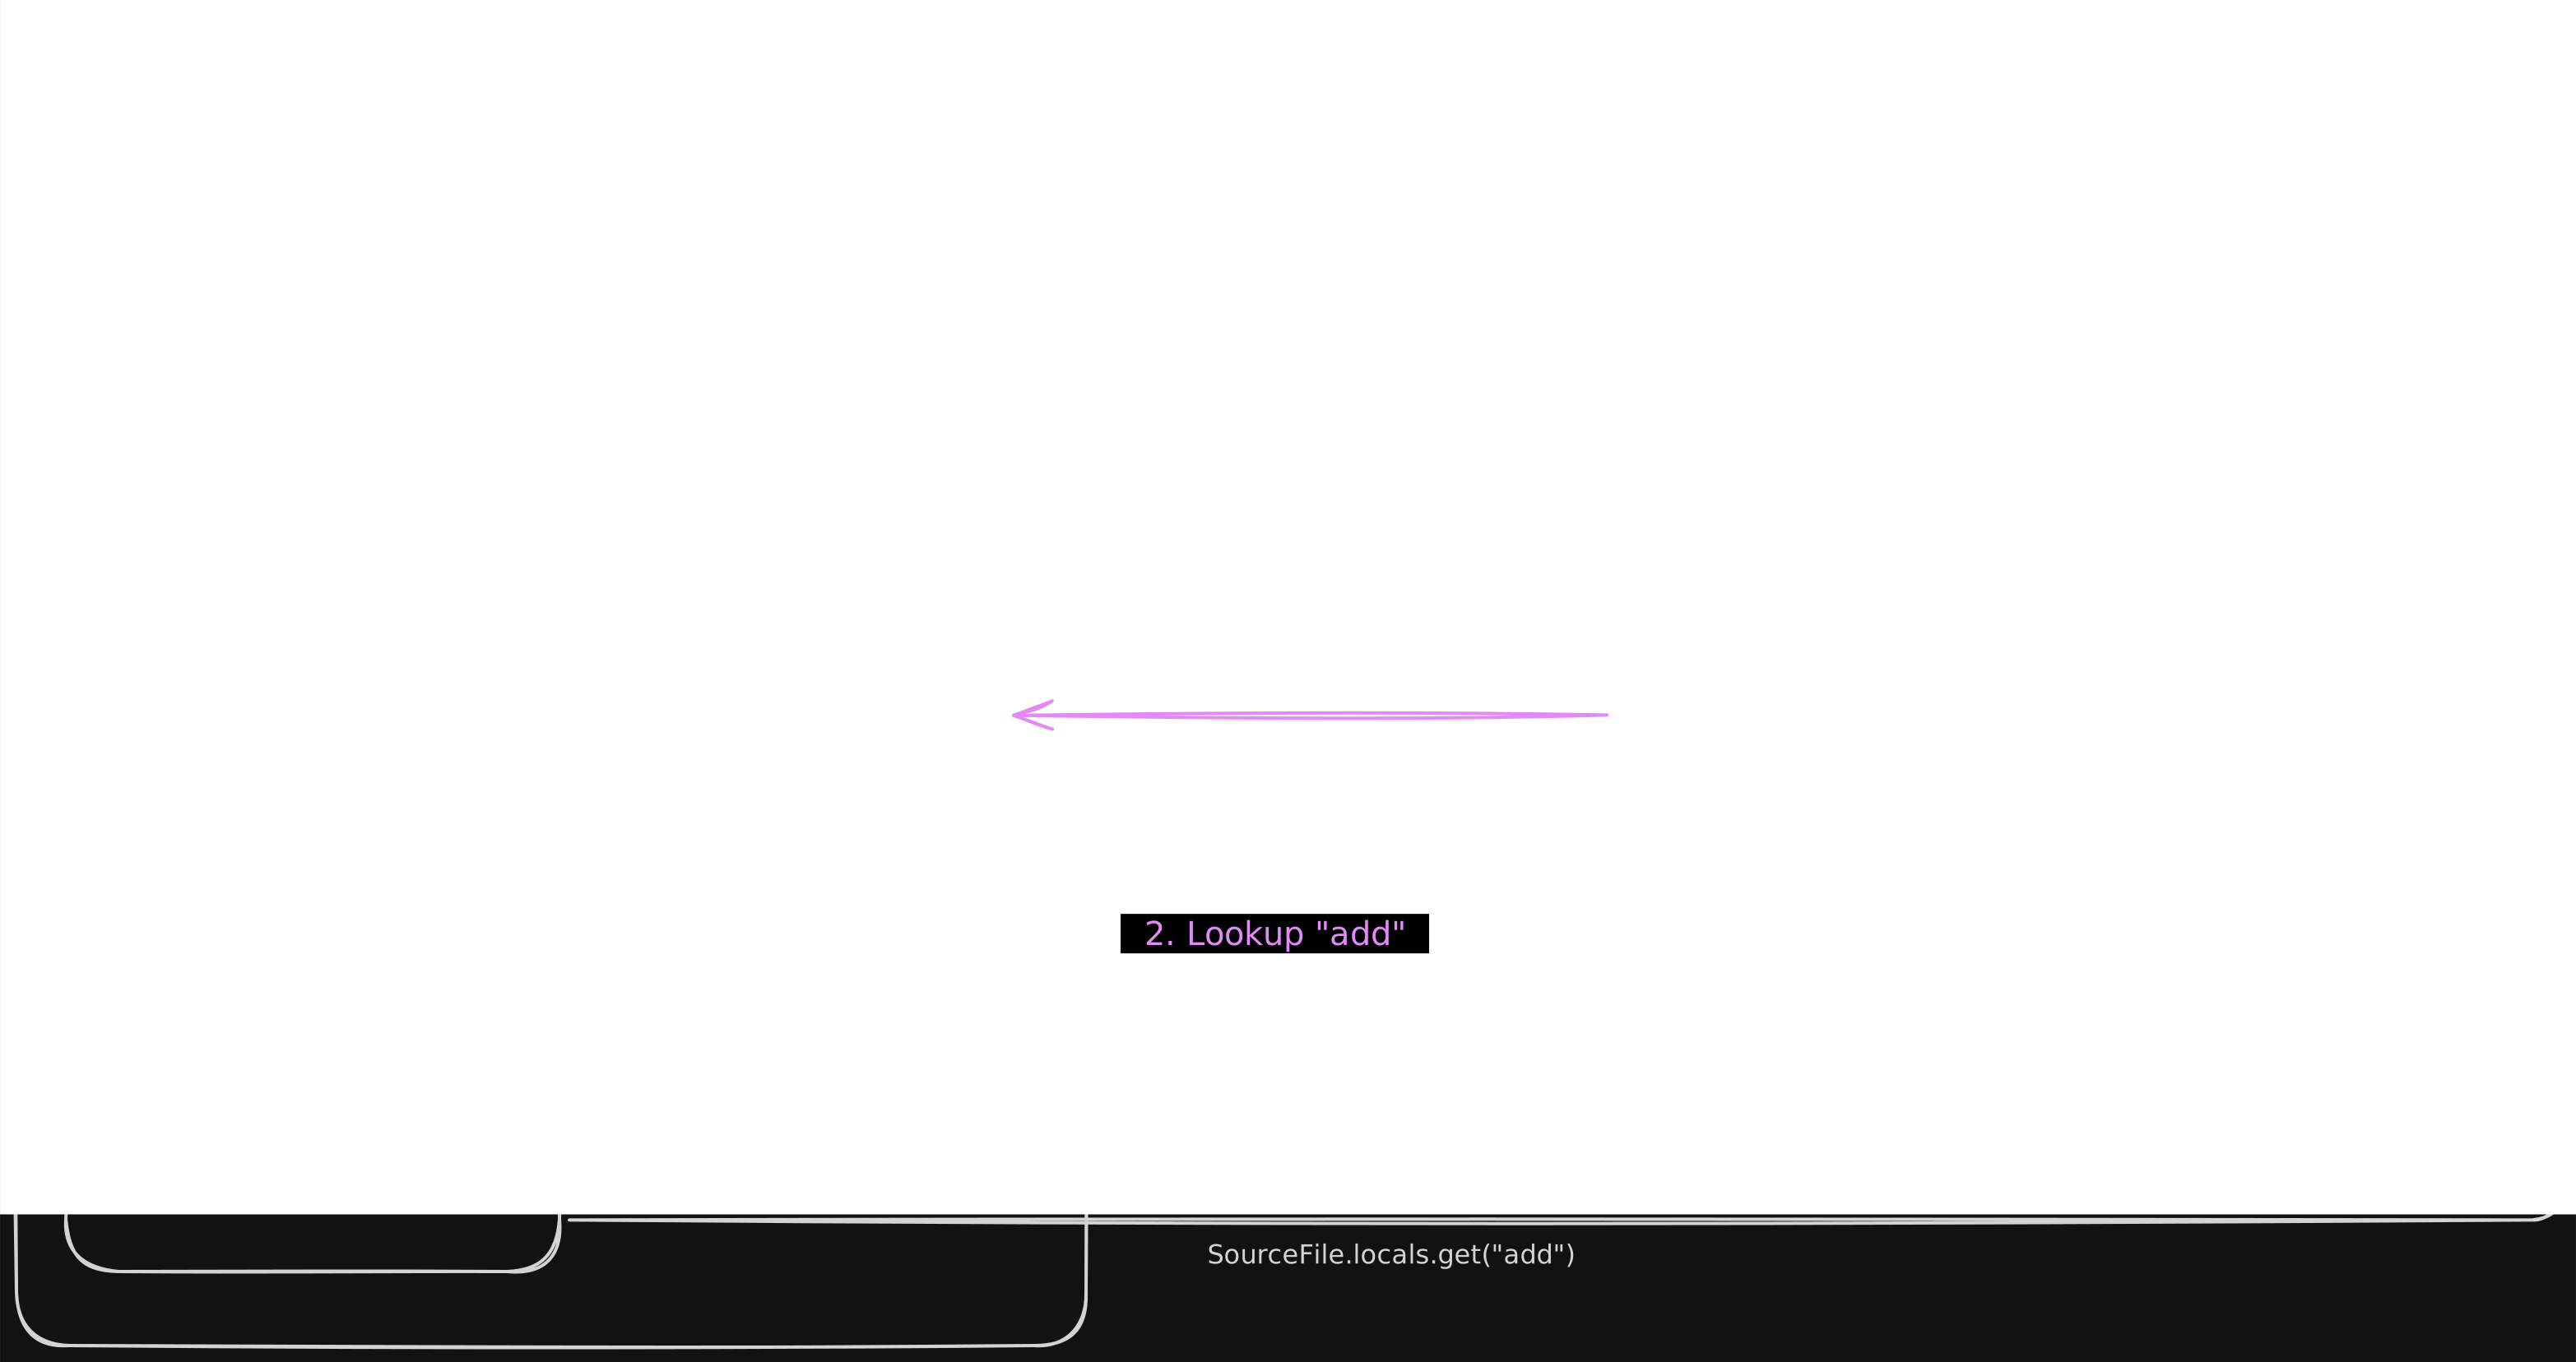
Checker はaddの参照を見つけるとgetResolvedSymbolという関数を使い、それが指している Symbol を解決します。
検査対象にでくわすと、図中2のようにその名前で登録されているシンボルをそのスコープの Symbol Table から探します。
そして3のように Symbol にさえ辿り着けば、その名前を宣言している AST ノードへ declarations から辿り着けます。
今回のadd関数にはパラメータに型注釈があるのでnumber, numberで確定します。返り値は明示されていないのでa + bからnumberと型推論されます。
これが分かった上で、add(1, "2") の実引数 1(number)と "2"(string)の型を、それぞれ対応するパラメータの型と比較します。2つ目の引数では number に string を渡しているため、エラーを出すわけです。
Checker の遅延評価
Checker の特筆すべき点として型情報の多くを遅延で評価するというのがあります。すべての型を解決するのではなく、必要な時に必要な部分の型だけ解決します。
- この値の型が知りたい
- 補完候補欲しい
- この代入が正しいか確認したい
こうした問い合わせごとに、プロジェクト全体の型をすべて計算する必要はありません。Checker は要求された型情報をその時点で計算し、結果をキャッシュします。
Bind の章で宣言と Symbol の対応関係の構築や SymbolTable の構築を見てきました。あのフェーズで AST を起点に構文、意味含む様々な情報にアクセスできるように参照が張り巡らされていました。
それらが名前解決の土台となり、Checker は関心のある AST ノードを起点として、必要な Symbol や型情報を遅延して解決できます。
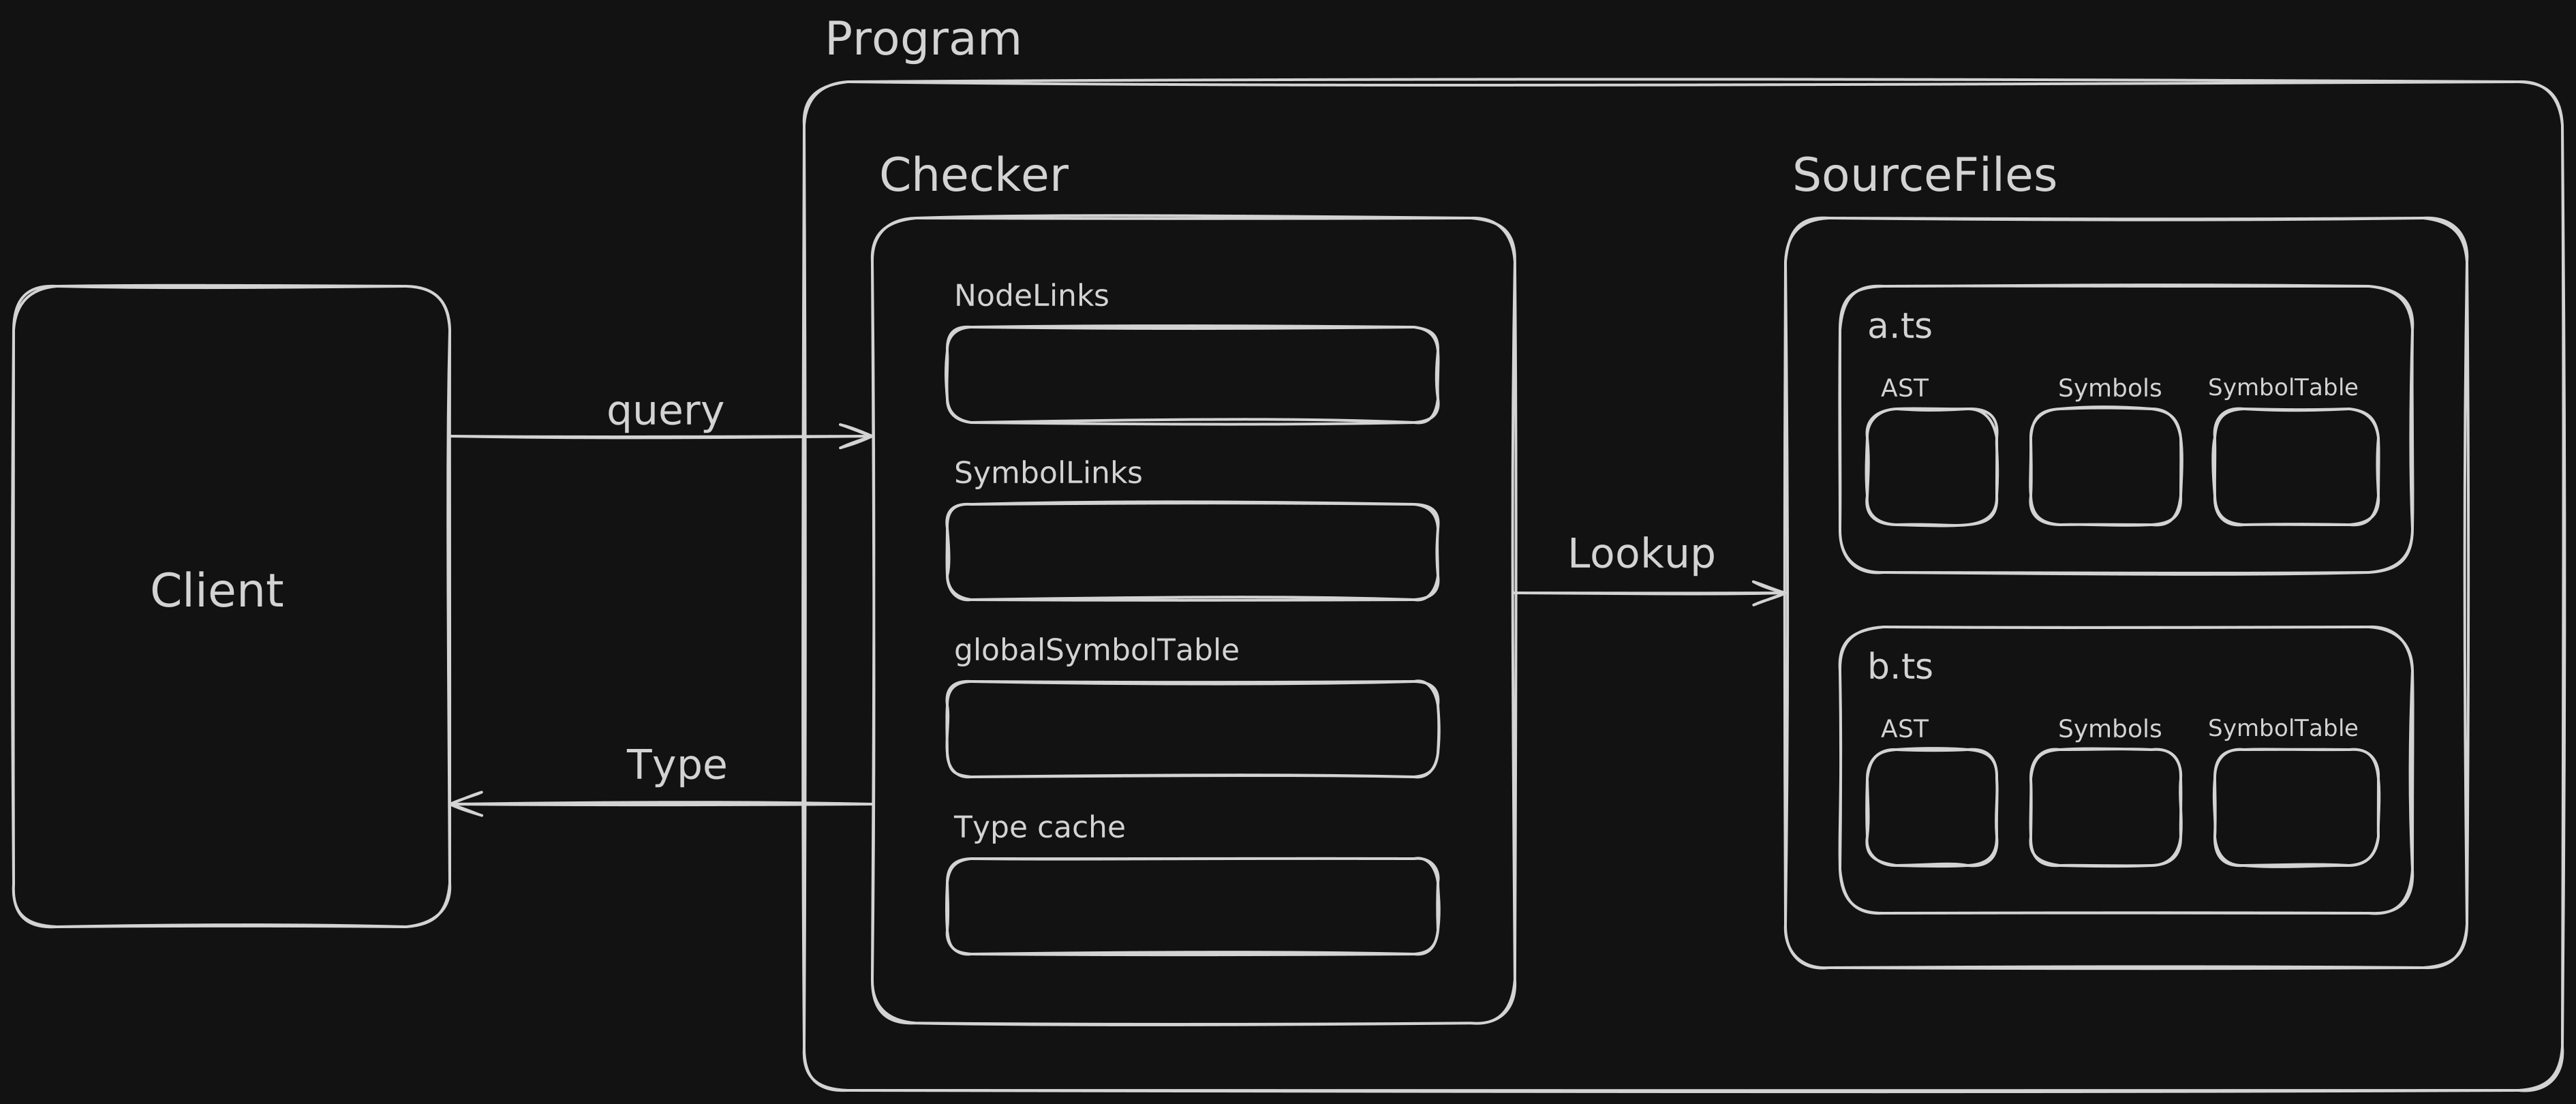
Language Service は Program と TypeChecker を保持します。補完やエラー表示で型情報が必要になると、TypeChecker に問い合わせます。それ以外の応用として typescript-eslint があります。
typescript-eslintgithub.com/typescript-eslint/typescript-eslinttypescript-eslint には type-aware linting と呼ばれる仕組みがあります。各ルールは AST を走査し、対象ノードへ到達すると Compiler API を通じて型情報を呼び出します。
このルールがオンの場合、事前に tsconfig などを基に Program と TypeChecker が用意され、対象ファイルの Parse や Bind などが実行されます。ただし、プロジェクト全体の型を最初にすべて計算するわけではありません。必要なノードへ到達してから型情報を要求し、Checker が遅延評価とキャッシュを使って解決した結果を基にチェックします。
type-aware linting をオンにすると実行時間が増えるのは、先ほどの Bind までの工程や実際の型計算も加わるためです。
Portにおける問題点
ここまでソースコードから型チェックまでの流れを説明してきました。独特でポートの際に問題となる部分が Bind の工程です。
大きな特徴としてAST が semantic 情報を負うということです。 Binder は AST に対して後からいろんな情報を追加していきます。コードを追っていくと本当に AST のオブジェクトのフィールドに値を代入しています。
node.symbol = symbol // Symbol
node.locals = ... // SymbolTable
node.flowNode = ... // CFA
node.parent = ... // Pointer to parent
TypeScript コンパイラでは、構文を表す AST に直接 symbol やフロー解析のための情報、親ノードへのポインタ、スコープの情報などを詰め込んでいきます。
結果として構文木+意味解析要素が1つの可変ツリーに同居します。別の層として持たせず1つの AST に直書きするわけです。
また、その実装の都合で循環参照を多く含むということです。Bind が済んだ時点の代表的な参照関係には、次のようなものがあります。
- 親子 AST ノードで相互に参照
- 宣言 AST ノードと Symbol 間で相互に参照
- member や export では Symbol の親子同士で相互に参照
どの循環が存在するかはノードや Symbol の種類によって異なります。一方メリットとしては AST を起点に自分の親、子、Symbol、スコープといった様々な情報にアクセスができます。
Part 1で触れた移植上の課題は、こうした参照関係を既存の挙動を保ちながら移植先の言語で扱うことでした。
次回
このパートでは TypeScript コンパイラの大まかな流れと、独特な部分について触れました。次の Part 3 からは、なぜこのような構造になっているのかに、時代背景から迫っていきます。
Footnotes
-
図上ではわかりやすさのために Scanner -> Parser としていますが、実際の実装は Parser から Scanner を呼び出して tokenize しています。 ↩
-
この単純な例であれば、AST だけで対処する実装も可能です。しかし、実際のプログラムでは複数のファイルを扱い、Global 宣言もあります。Mapped Type、Generics、Conditional Types、Namespace Merging なども考慮すると、AST だけで型を判定するのは難しくなります。 ↩
-
正確には、Checker の初期化時に全 SourceFile を Bind し、グローバル SymbolTable を構築します。 ↩