Exploring the TypeScript Compiler Part 4: Roslyn and the Red-Green Tree
本記事は tskaigi 2026 Day2の制約と時代から読み解くTypeScriptコンパイラ設計史の増補改訂版の Part 4です。
- Part 0: Overview
- Part 1: Why Go?
- Part 2: Inside the TypeScript Compiler
- Part 3: Why TypeScript?
- Part 4: Roslyn and the Red-Green Tree
- Part 5: JavaScript Madness🫠(Coming soon)
- Part 6: What Changes with Go(Coming soon)
ソースコードの編集操作は人間が行うにしろ Agent が行うにしろ、多くのケースで巨大な構文木のごく一部に対する変更です。ツールにはその変更に関係する箇所だけを再計算し、フィードバックを素早く返すことが求められます。
わかりやすさのために IDE やエディタといった対話的なツールを考えてみてください。動作の起点が必ずしもルートであると限らず、ユーザーが今編集している箇所やカーソルをおいている箇所に対して、必要な結果を素早く返すことが求められます。例えば、コードを変更すれば型エラーを、識別子にカーソルを合わせればホバー情報をすぐに確認できなければなりません。
ところが、何も工夫しなければ、編集が発生するたびに構文木をルートからたどり直し、プロジェクト全体を再計算することになります。キーを入力するたびにプロジェクト全体へ npx tsc を実行して作業するようなものです。
C# Roslyn
このような要件に対して、非常に面白い解法を出したのが C#のコンパイラ Roslyn です。
dotnet/roslyngithub.com/dotnet/roslyn従来のコンパイラは、外部のツールから見るとブラックボックスでした。ソースコードを入力してオブジェクトファイルやアセンブリを得られても、コンパイル途中の解析結果を API 経由で利用する手段が十分に提供されていませんでした。 コンパイル中にコードに関する多くの重要な情報がメモリに載っているにも関わらずそれを見ることはできない上に、終了すると揮発してしまう。
その解析結果を API 経由で取得できるようにし、開発に活用するというアイデアが元になっています。
Roslyn Overviewgithub.com/dotnet/roslyn/blob/main/docs/wiki/Roslyn-Overview.mdコンパイラとして動作し、API 経由で中間解析結果へアクセスでき、十分な応答速度も出せる。この要件を満たすために生まれた実装パターンが赤緑木(Red-Green Tree)です。
Persistence, façades and Roslyn’s red-green trees というブログポストは赤緑木のデザインについて書いている非常に貴重な資料です。そこで挙げられたデータ構造に求められた5つの性質について見ていきます。
1. immutable
immutable とは、一度作成された値は、その後その値自体を変更できないという性質を指します。ゆえに、内容を変更するときは変更後の新しい値を作成します。
イメージを掴むために JS で値の immutable な更新操作を示します1。
const a = { name: "koupenchan", age: 9 };
const b = { ...a, age: 10 }; // オブジェクトaを破壊せずに新しいオブジェクトとして作る
React で次のように hooks の更新関数を書いたことがある人も多いはずです。
const [user, setUser] = useState({
  name: "Koupenchan",
  address: {
    city: "Toronto",
    country: "Canada",
  },
});

setUser({
  ...user,
  address: {
    ...user.address,
    city: "Vancouver",
  },
});
対して mutable な更新は次のようになります
const a = { name: "koupenchan", age: 9 };
a.age = 10;
一度作ったら変わらないという前提があることでキャッシュとの相性が良い性質です。同じデータは途中で変化しないので、一度計算した結果を再利用しやすくなります。
また、データを安全に共有できます。複数の解析が同じデータへ同時にアクセスしても、処理の途中で書き換えられないためです。
2. The form of a tree
ここで扱うのはプログラムのソースコードなので木構造をしたものである必要があります。
3. Cheap access to parent nodes from child nodes
一般的なエディタや IDE の操作を思い浮かべてみてください。基本的にはユーザーが開いた任意のファイルやノード起点で解析が始まります。常に全てを解析してから表示するとなると応答が遅くなりがちで体験として良くないからです。
これを実現するために木に自身の親へのポインタを持たせるという手法があります。木構造は通常子への参照を持っているのみですが、それに加えて親への参照も持ちます。上下に木を辿れる状態だと楽に現在位置や所属する function やスコープなどの文脈情報に素早くアクセスできます。
4. Map a node to a character offset
構文木のノードから、元のソースコード中の文字オフセットを求められることです。エラー箇所への下線やリファクタリングなどには、ノードがソースコードのどの範囲に対応するかを知る必要があります。
5. Persistence
データ構造の永続性とは、更新後も旧版を壊さずに利用できる性質です。1で見た immutable な更新では、元の値を変更せずに新しい値を作るため、旧版への参照を保持していれば、更新前の状態も利用できます。全ての履歴を永久に保持する必要はなく、不要になった版への参照は手放せます。
const a = { name: "koupenchan", age: 9 };
a.age = 10; // 元のオブジェクトが書き換わり、aから更新前の状態を参照できなくなる
const oldVersion = { name: "koupenchan", age: 9 };
const newVersion = { ...oldVersion, age: 10 };
console.log(oldVersion.age); // 9
console.log(newVersion.age); // 10構文木でもノードが immutable なら、変更されていないノードを旧版と新版から安全に参照できます。旧版のルートへの参照を残しておけば、更新後も旧版の構文木を利用できます。
Structural Sharing
前節では persistence を更新後も旧版を利用できる性質として説明しました。元記事では特に、編集時に既存ノードの大部分を再利用できることを persistence と呼んでいます。この再利用を効率よく実現するのが structural sharing です。
By persistence I mean the ability to reuse most of the existing nodes in the tree when an edit is made to the text buffer. Since the nodes are immutable, there’s no barrier to reusing them, as I’ve discussed many times on this blog. We need this for performance; we cannot be re-parsing huge wodges of text every time you hit a key. We need to re-lex and re-parse only the portions of the tree that were affected by the edit because we are potentially re-doing this analysis between every keystroke.
ここでいう persistence(永続性) とは、テキストバッファに編集が加えられたときに、既存のツリーのノードの大部分を再利用できる性質のことです。 ノードは immutable なので、それらを再利用するうえで妨げになるものはありません。この点については、このブログでもこれまで何度も説明してきました。 これはパフォーマンス上必要です。キーを1回押すたびに、巨大な量のテキストを毎回すべて再パースするわけにはいきません。 そのため、編集の影響を受けたツリーの部分だけを再度字句解析や構文解析します。この解析処理は潜在的にはキー入力のたびに毎回やり直されるからです。(強調は筆者による)
エディタという木の一部分に対して高頻度で操作が走るという要件が前提としてあり、引用にあるとおりパフォーマンス面での工夫が必要です。
またメモリ消費の観点でも問題があります。1の immutable では mutable な操作に比べていくつか良いことがあると述べました。一方で実直にやるともちろんデメリットがあります。 次のようなソースコードの木があると考えてみてください。
CAUTION
ここからC#のサンプルコードを用います。また、わかりやすさのためASTは簡略化しており実際のものではありません。
var t = 1 * 2 + 4;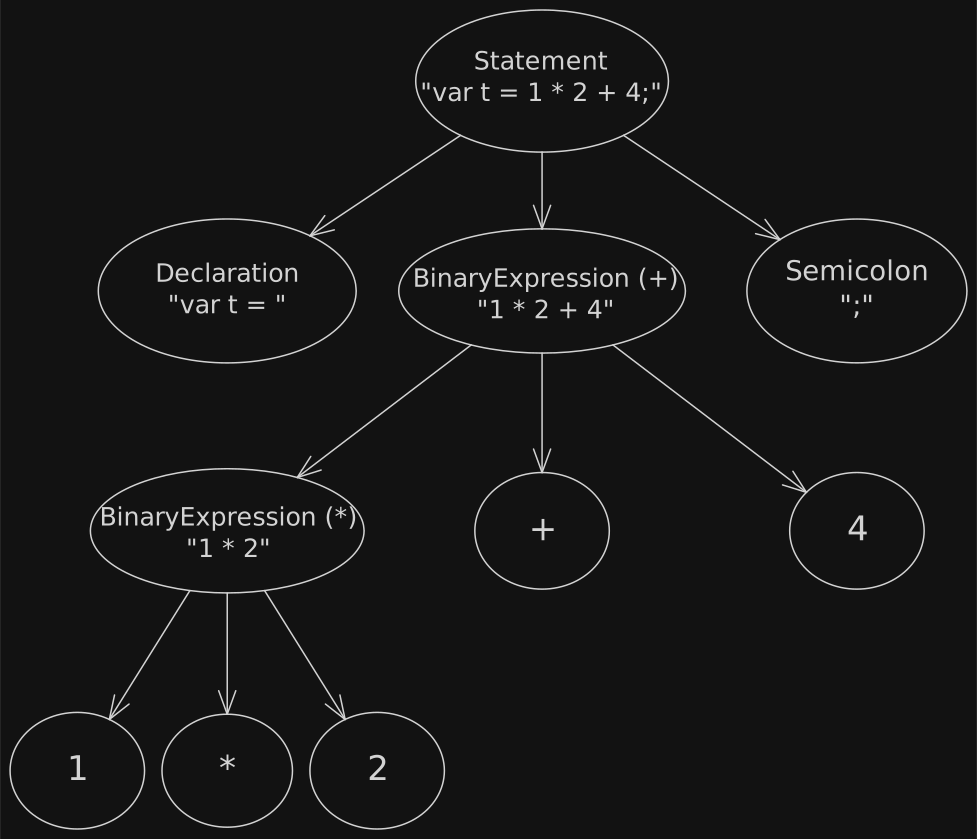
var t = 1 * 2 + 4; を表す構文木次に4を6に編集したいとします。immutable に保つには一度作成された値は、その後その値自体を変更できないということを守らないといけません。壊さないように新しい木を作成します。
4のノードが変わったので、それを参照している先祖の1 * 2 + 4とvar t = 1 * 2 + 4のノードも作り直しです。
var t = 1 * 2 + 6;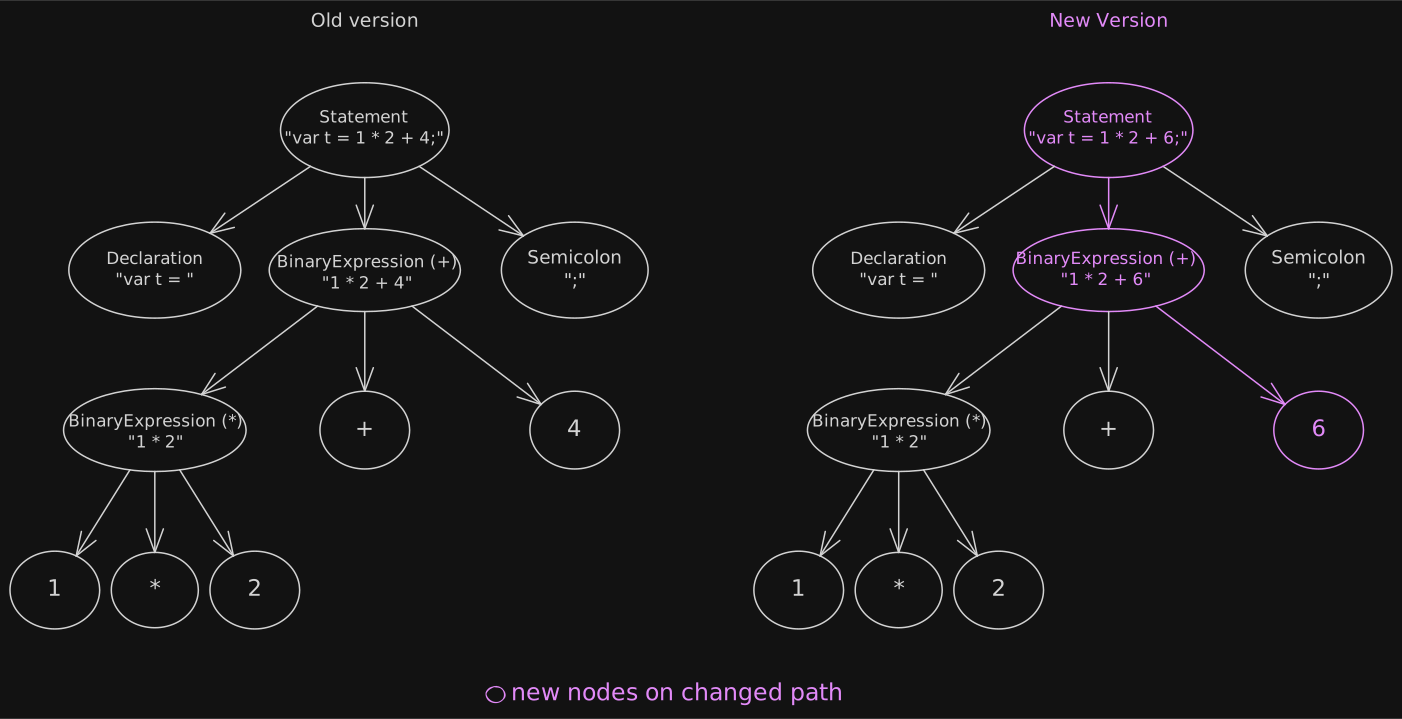
4 を 6 に変更したときの差分ほんの一箇所変えただけなので木の大部分はほとんど同じ形をしています。ここで、素朴に木全体をコピーして新版を作り、過去の版も保持するとします。
素朴に全体をコピーする実装では変更していない部分まで複製してしまいます。 これをもっと巨大で依存も複雑なコードベースで同じように N 回編集すると考えてみてください。
なんだかメモリを大量に圧迫しそうな気がしてきましたね。
一方で編集をしても木の大部分は同じケースが多いということ、immutable に保ってきたおかげで、同じノードを旧版と新版の両方から参照しても書き換わる心配がないことに注目します。ここでのアイデアは非常に明白です。同じところは旧版と共有してしまえばいいのです。
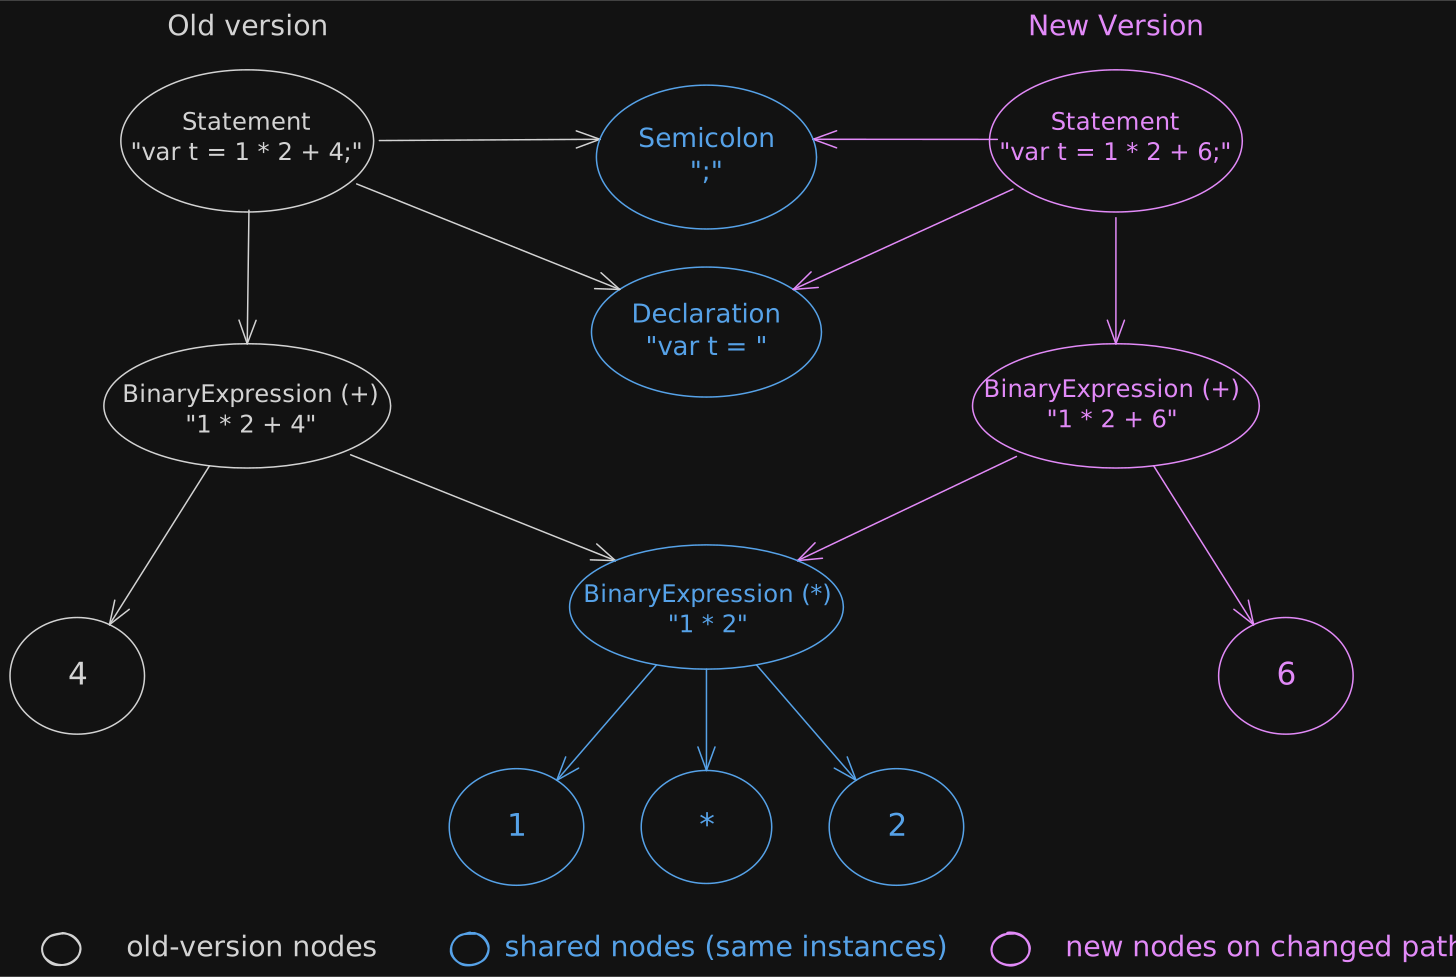
これにより、必要な旧版を保持しながら immutable も維持でき木全体をコピーする場合よりメモリ消費を抑えられます。
両立するための問題点
実装する際に求められた5つの性質を見てきました。しかし全てを両立するimmutableかつ永続性があり、親ポインタにアクセスできてコメントなども保持できる木は、実現が非常に困難です。
まず第一に親子で相互に参照するかつ immutable でなくてはいけないという点です。 immutable, persistent の説明では親から子方向へのみの木で考えました。しかし、親方向へも参照を持つ木では同じことは成立しません。
親を作るために子が必要です。一方で子を作るためには親が必要です。しかも一度作ったものは変更できません。構築時にどちらを先に作るか?という問題に突き当たります。
第2に親子で相互参照していると、structural sharing がしにくいという問題があります。コードの4を6に編集するとします。
4以外の木は全く同じなので共有して節約したいところです。しかし、親への参照を持つという前提が加わると状況が変わります。
単方向であれば変更した4とその先祖以外は共有できるのですが、今回は変更していない左辺のサブツリーが親である1 * 2 + 4を参照しています。その親が変わったので巻き添えで作り直しになります。
第3の問題として絶対位置を保持してしまうと一部の編集で大量の Node を作り直さないといけなくなるということです。
- エラー箇所に赤線を引く
- Rename / Go to Definition / Refactoring といったアクション
- 診断メッセージで"10〜14文字目がエラー"と返す
これらを実現するには、構文木と元のソースコードを対応させる位置情報が必要です。次のように、各ノードが開始位置である start 保持するとします。
ここで変数名をtからtotalへ変えてみましょう。すると直下の1 * 2 + 4と;のスタート位置は4つ後ろずらさなければなりません。
ここでもまた一度作ったものは変更しない、新しく作るという制約が響いてきます。ノードの絶対位置のみピンポイントで更新できないので全部木は作り直しです。
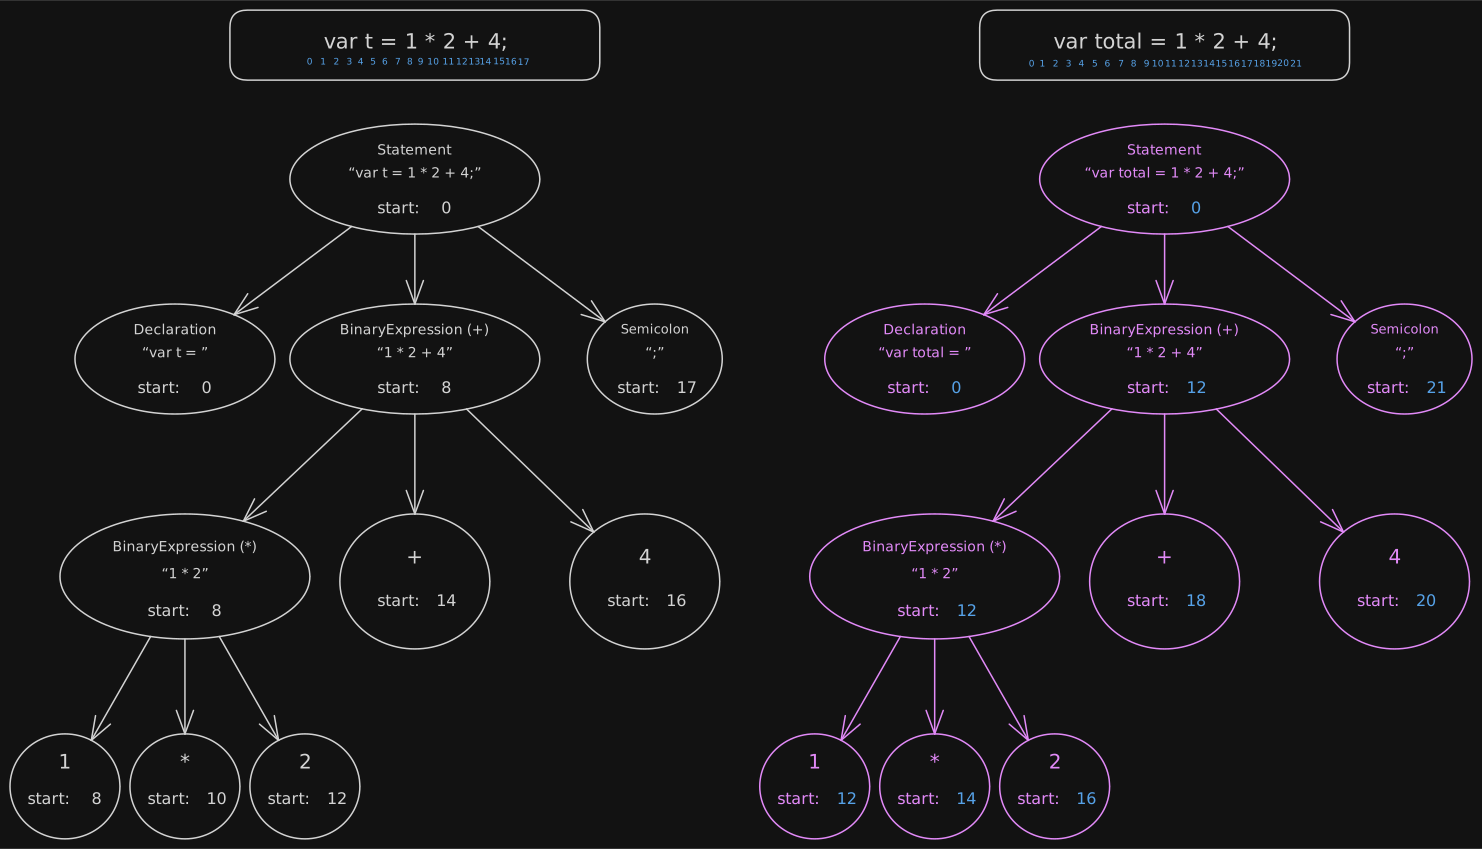
t を total に変更すると後続ノードの絶対位置がずれるRed Green Tree
上記の例から、それぞれの性質を両立する難しさがわかると思います。この制約に対する解の1つとして編み出されたのが Red Green Tree というデータ構造です。
Green Tree
Green Tree は以下のような特徴を持ちます。
- immutable かつ Persistent
- 自身のwidth、子ノードや Trivia を持つ
- 絶対位置を持たない
- parent を持たない
構文情報が主で、Structural Sharing もでき、同時読み取りも安全で、過去バージョンへの参照も容易に行えます。また、位置を持たず自身のwidthを保持するというところが非常に重要です。
先ほどのサンプルコードのようにvar t = 1 * 2 + 4;をvar total = 1 * 2 + 4;に編集するとしましょう。
位置を持っていると後続のノードの位置がずれてしまいます。一方、width なら編集箇所からルートまでの経路上にあるノードだけを新しく作ればよく、経路外にある子ノードは width が変わらないため、そのまま使いまわせます。
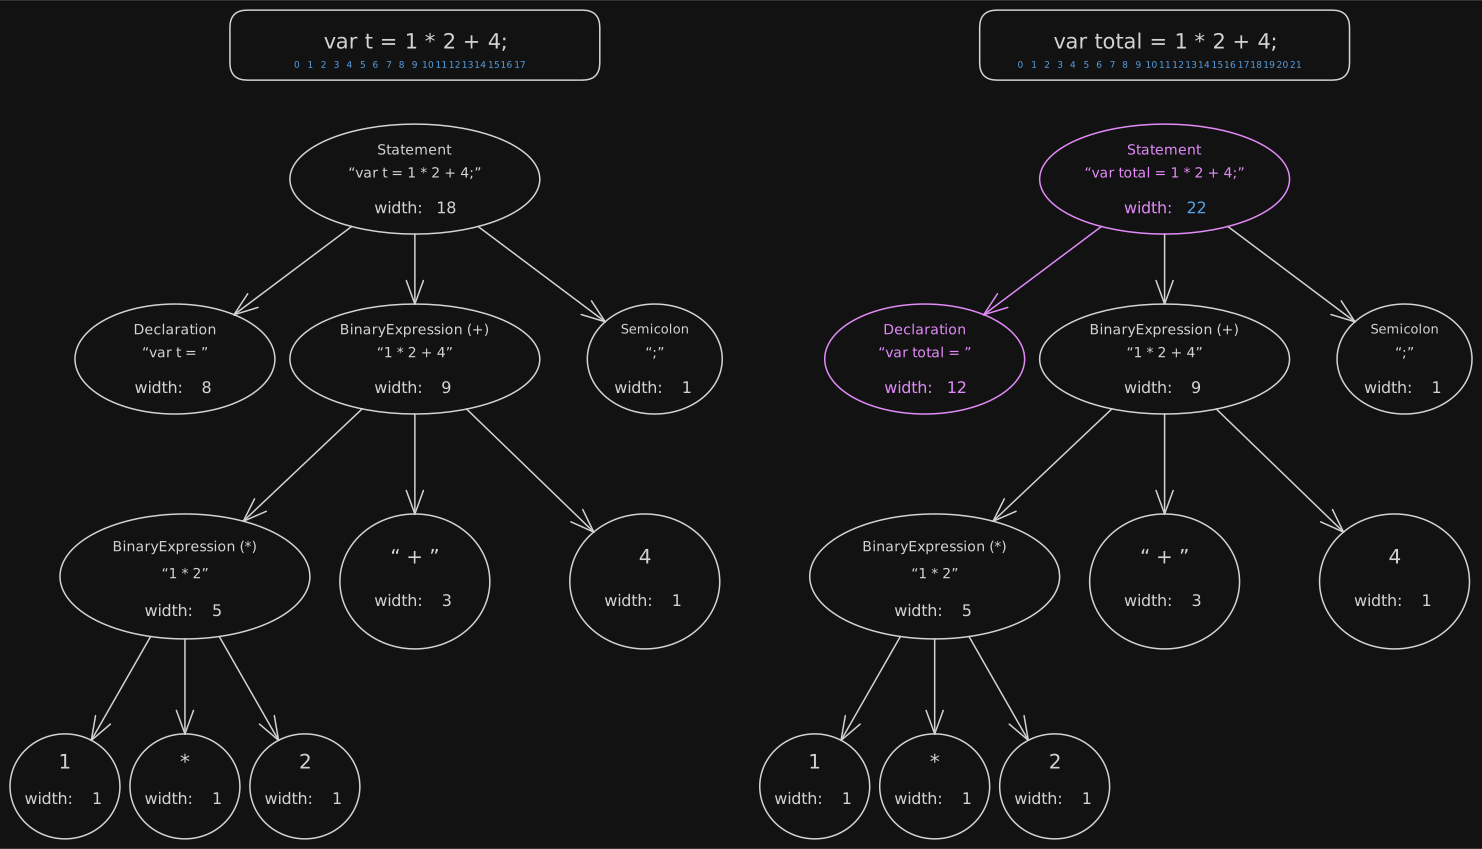
Red Tree
RedTree は GreenTree のラッパーで2つの大きな特徴を持ちます。
- 親ノードと絶対位置を持つ
- 必要になった子ノードだけ遅延生成する
必要な文脈情報だけを利用時に遅延生成することで素早くアクセスできます。位置は、対象ノードまでの経路にある親や兄弟ノードの width を加算して求めます。
例えばvar t = 1 * 2 + 4;の4の位置がどこか知りたいとします。
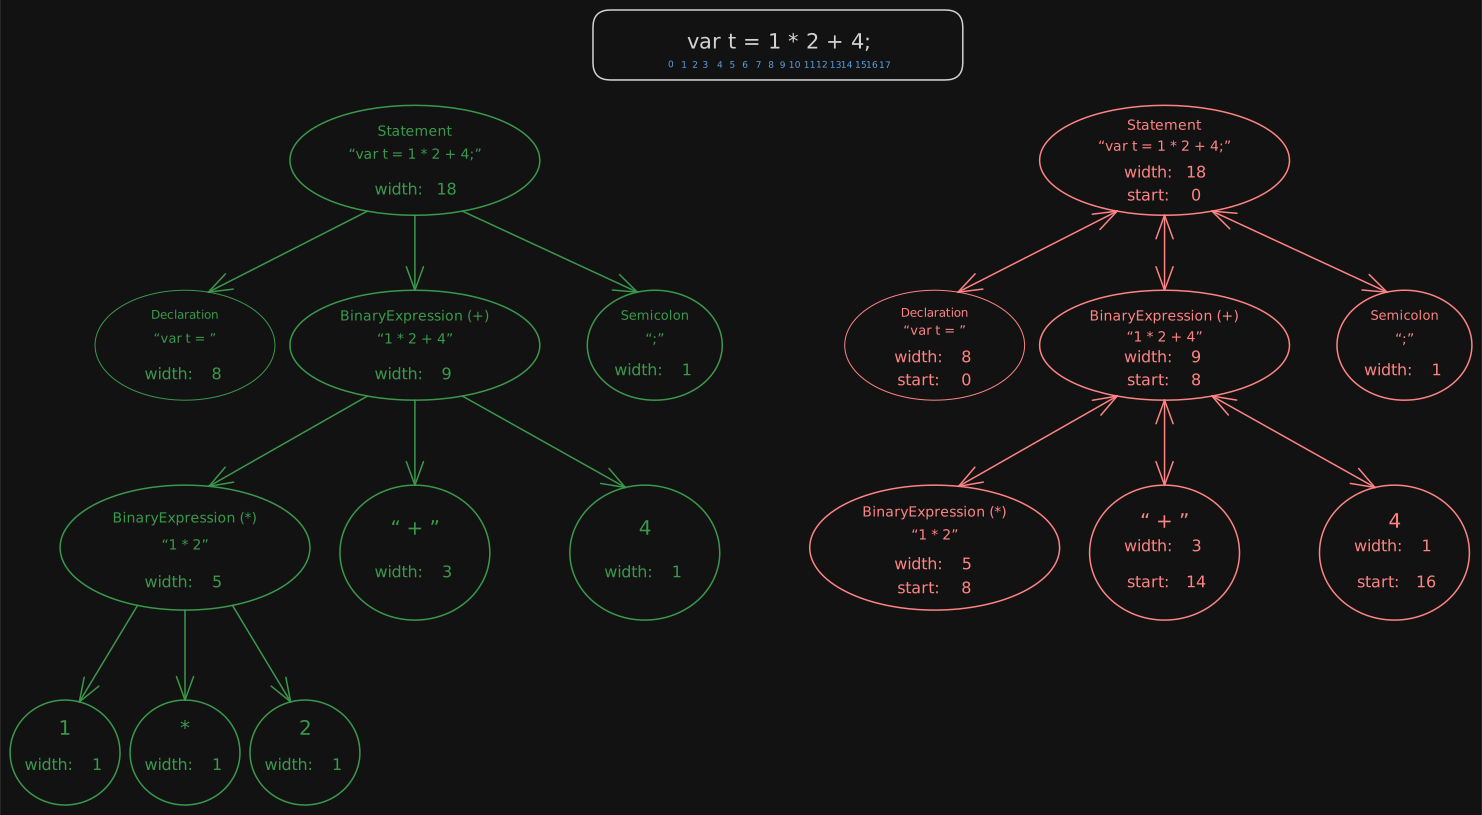
ルートの開始位置は0です。式1 * 2 + 4は、その前にあるvar t =の7文字と直後の空白1文字を合わせた width が8なので、開始位置は8になります。
次に4の開始位置を求めます。式の開始位置8に、左辺の1 * 2の width である5と、演算子+および前後の空白を合わせた3文字を足します。8 + 5 + 3 = 16なので、4の開始位置は16です。
また、親から辿ってきているので、4の親ノードが何かということも知ることができます。簡略化すると、4に対する Red Node は次のようになります。
var redNode = new RedNode
{
    GreenNode = greenNode,
    Position = 16,
    Parent = binaryExpression
};
全ての Green Node を一度にラップする必要はなく、必要なノードに至る経路に沿って Red Node を遅延生成することで、文脈情報にアクセスできます。
編集後は新しい Green Tree に対して新しい Red Tree を必要に応じて生成します。旧版の Red Tree を参照している利用者は、引き続き旧版を参照できます。
親や絶対位置を持たない Green Node は版をまたいで共有し、親や絶対位置を持つ Red Node は各版の文脈に合わせて作ります。この役割分担によって、構造共有と親・位置へのアクセスを両立しています。
次回
Roslyn から生まれ、複数の性質を両立する Red Green Tree について解説しました。IDE 統合に適したデータ構造であることがわかります。
しかし、TypeScript コンパイラは Roslyn の後発にも関わらずこのデータ構造は採用していません。
それがなぜなのか、代わりにどうしているのか JavaScript の制約を見ながら追っていきます。
Footnotes
-
この例はイメージのためであり、実際にオブジェクト自体は不変ではありません。
constが禁止するのは単に変数への再代入です。 ↩